11 月 3 日,LinkedIn 将开始与 Microsoft 及其关联公司分享你的数据,用于 AI 训练。你已被默认加入,但仍有时间采取行动。
这项新的 LinkedIn AI 策略似乎符合 Microsoft 的整体战略(新窗口),即向其 AI 生态系统输送更多数据。就在几周前,该公司宣布Word 文档将默认保存到 OneDrive,Excel 和 PowerPoint 也将随后跟进。此举引发了担忧:将个人或工作文件迁移到 Microsoft 云端可能与 AI 训练产生交集,尤其是考虑到 Microsoft 对 ChatGPT 开发商 OpenAI 的数十亿美元投资。
LinkedIn 为何要更改其数据隐私设置?
9 月 18 日,LinkedIn 宣布(新窗口),自 2025 年 11 月 3 日起,欧盟、欧洲经济区(EEA)和瑞士用户的数据将与 Microsoft 及其关联公司分享,用于 AI 训练。在该日期之后你仍可选择退出,但这不会影响过去的数据:你在此之前在 LinkedIn 上分享的信息都可能被任意使用。
此前,一起加州诉讼指控 LinkedIn(新窗口) 秘密与第三方分享私有消息以训练 AI 模型。该公司拒绝了这些指控,并在不久后更新了其隐私文档,明确说明英国、欧洲经济区和瑞士用户不受这些更改的影响。但如今,该平台正将同样的 AI 训练策略扩展到这些地区。
LinkedIn 将使用哪些数据进行 AI 训练?
以下是可能被用于 AI 流程的 LinkedIn 数据类型:
- 个人资料数据,包括姓名、照片、当前职位、过往工作经历、教育背景、位置、技能、发表的作品、专利、技能认可和推荐。
- 求职相关数据,例如简历、筛选问题的回答以及求职申请的详细信息。
- 会员内容,例如帖子、文章、投票回答、贡献和评论。
- 群组数据,包括活动和消息。
- 反馈,包括你提供的评分和回答。选择退出后,LinkedIn 仍可能使用你的反馈并将其与你关联。
以下内容被明确排除在外:私有消息、登录凭证、付款方式、信用卡详细信息,以及可关联到特定个人的会员提供的薪资或求职申请数据。
如果 LinkedIn 有理由认为你未满 18 岁——例如你还在读中学或当地同等学力的学校——即使你的设置处于开启状态,你的数据也不会被用于训练内容生成型 AI 模型。
LinkedIn 明确表示,所有这些信息都可能被其生成式 AI 模型使用,即用于生成推荐帖子或自动起草消息等内容的系统。虽然它提供了一个退出设置,但仅适用于内容生成型 AI。要阻止 LinkedIn 将你的反馈用于非内容类 AI 模型(例如个性化、安全、信任或反滥用),唯一的办法是提交数据处理异议表。
如何退出 LinkedIn 上的 AI 训练
以下是如何在隐私设置中退出 AI 训练的方法:
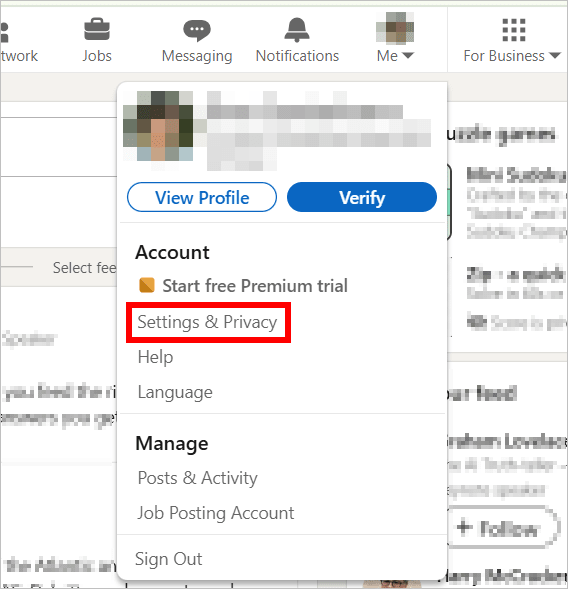
- 选择设置与隐私。
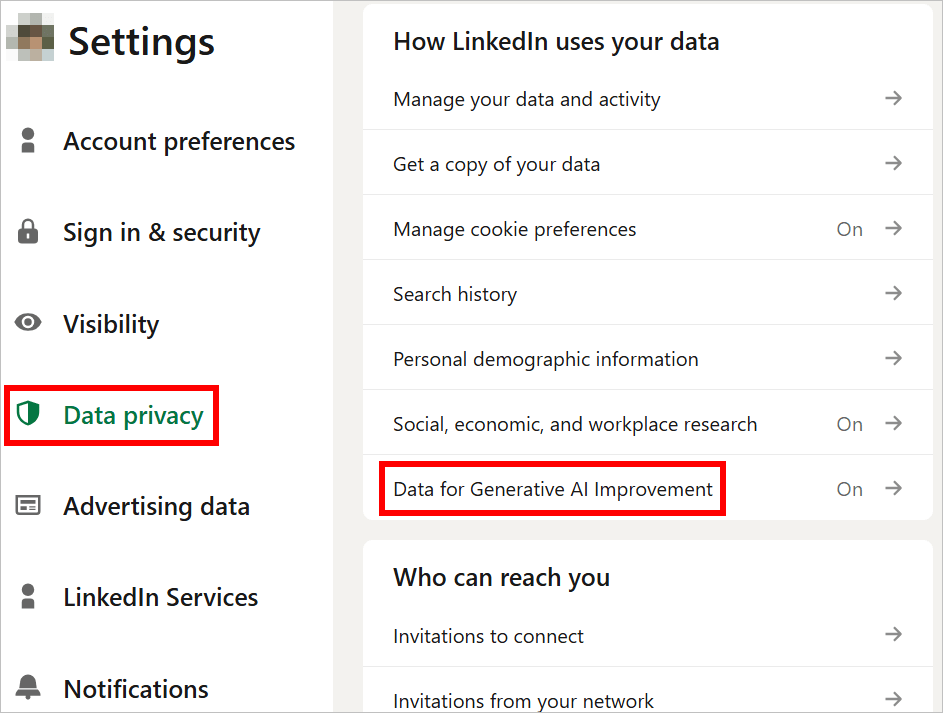
- 前往数据隐私 → 用于改进生成式 AI 的数据。
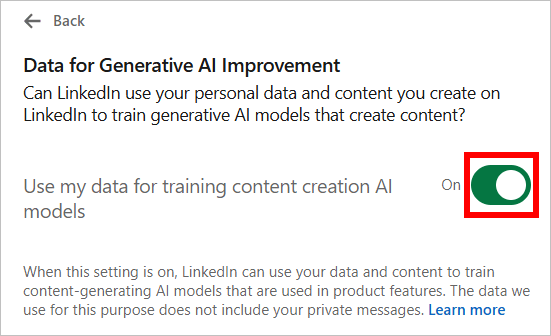
- 关闭将我的数据用于训练内容创作 AI 模型。
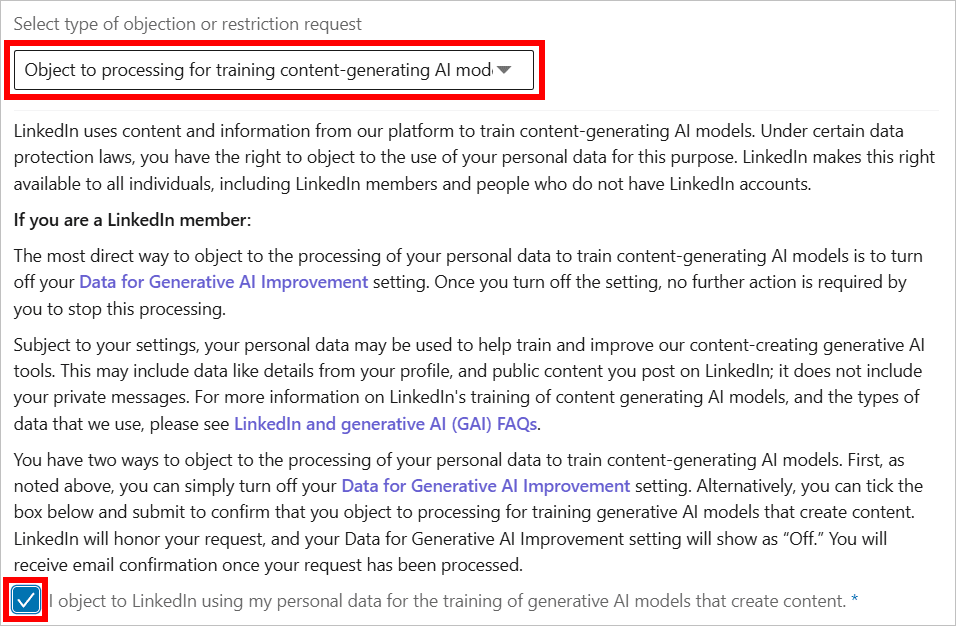
- 访问数据处理异议表(新窗口),选择反对处理数据以训练内容生成型 AI 模型,然后发送请求。如果你的个人数据被某会员分享到 LinkedIn 上,非会员也可以提出异议。
如果你在美国或 LinkedIn 已推出这些设置的其他地区,你可能已经受到影响。而在 11 月 3 日之后,欧盟、欧洲经济区和瑞士的用户也将被包括在内。但你仍然可以采取措施来减少自己的数据暴露:
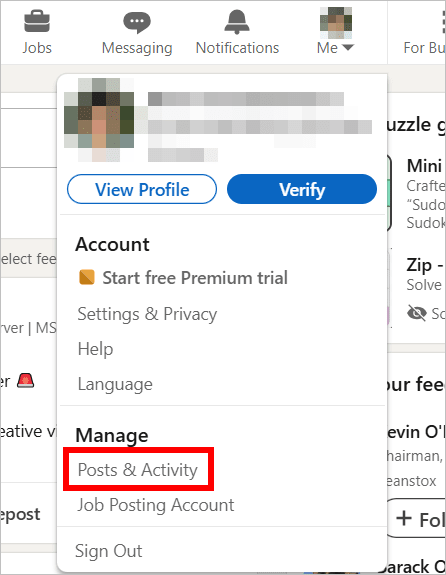
- 检查并清理可能包含敏感信息的旧帖子。例如,你可以前往管理 → 帖子与动态,轻松查看你发布过的所有内容。
- 检查你的帐户资料,删除任何你不希望分享给 LinkedIn AI 模型的内容,例如生日、电话号码或地址。
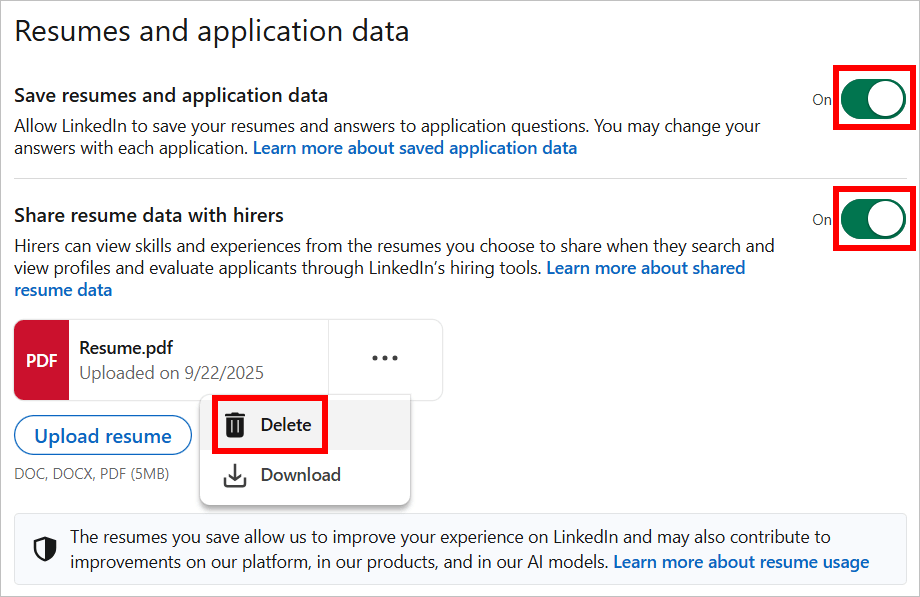
- 前往数据隐私 → 求职申请设置,删除你上传到 LinkedIn 的所有简历。
- 请假设你发布的任何公开内容(例如技能、评论或行业见解)都可能被用于训练 AI。
注意:如果他人分享了你的信息,这些信息仍可能进入 AI 训练。例如,如果同事转发了你的文章或提到了你的简历,这些信息仍可能被拉入训练流程。
你的职业数据不应成为 AI 训练的燃料
LinkedIn 并不是第一个通过默认让用户加入来扩充其 AI 训练数据集的平台。例如,Facebook 已经(新窗口)在使用公开帖子(新窗口),Google 最近也与 Reddit 达成了一项协议(新窗口)。但作为一个存储简历、求职申请和职业互动的招聘平台,LinkedIn 的此举引发了人们的担忧:你的数字职业身份会如何为 AI 流程提供燃料。
在 Proton,我们相信你的职业履历和职业数据应该完全属于你自己。这就是为什么我们构建带有端到端加密的工具,这样无论如何我们都无法访问你的私有信息,我们也绝不会用它来训练 AI 模型。我们的业务是保护你的数据,而不是将其挪作他用。