当今的儿童从上网的那一刻起,就生活在一类旨在收集并留存其数据的系统之中。最初只是一个学校帐户、一个第一个电子邮件地址,或一个消息应用,但它们日后可能成为记录孩子行为、人际关系和身份的长期档案。而这些数据可能在多年之后仍可供访问。
Proton 的新研究显示了这一系统在大规模应用下的后果。过去十年间,Google、Apple 和 Meta 已向美国当局分享了超过 3.5 million user accounts 的数据——自各公司开始报告此类请求以来,这一数字增长了 770%。若再加上依据 Foreign Intelligence Surveillance Act (FISA) 披露的数据,总数将激增至 6.9 million。
这就是任由大型科技公司定义儿童在线生活架构的真正危险所在。出于商业目的收集的数据——用于精准投放广告、训练 AI 和构建用户画像——日后可能被暴露于国家监控之下。如果任由这一体系不断加深,下一代将继承一个这样的互联网:隐私不是被逐渐削弱,而是从设计之初就被排除在外。
- 研究揭示了大型科技公司与政府合作的哪些情况
- 之所以如此,是因为大型科技公司始终让您的数据保持可读状态
- 父母们已经知道这一体系辜负了他们的孩子
- 如何从一开始就减少孩子暴露在数据收集之下
- 下一代不必继承这个有缺陷的体系
研究揭示了大型科技公司与政府合作的哪些情况
我们的 2025 年分析发现,政府对大型科技公司所持用户数据的访问在此前十年间急剧增加。最新的透明度报告显示,这一趋势仍在延续。
美国当局继续依赖大型科技公司获取用户数据
2014 年末至 2025 年初,Google、Meta 和 Apple 应例行请求,向美国当局分享了超过 3.5 million user accounts 的数据。
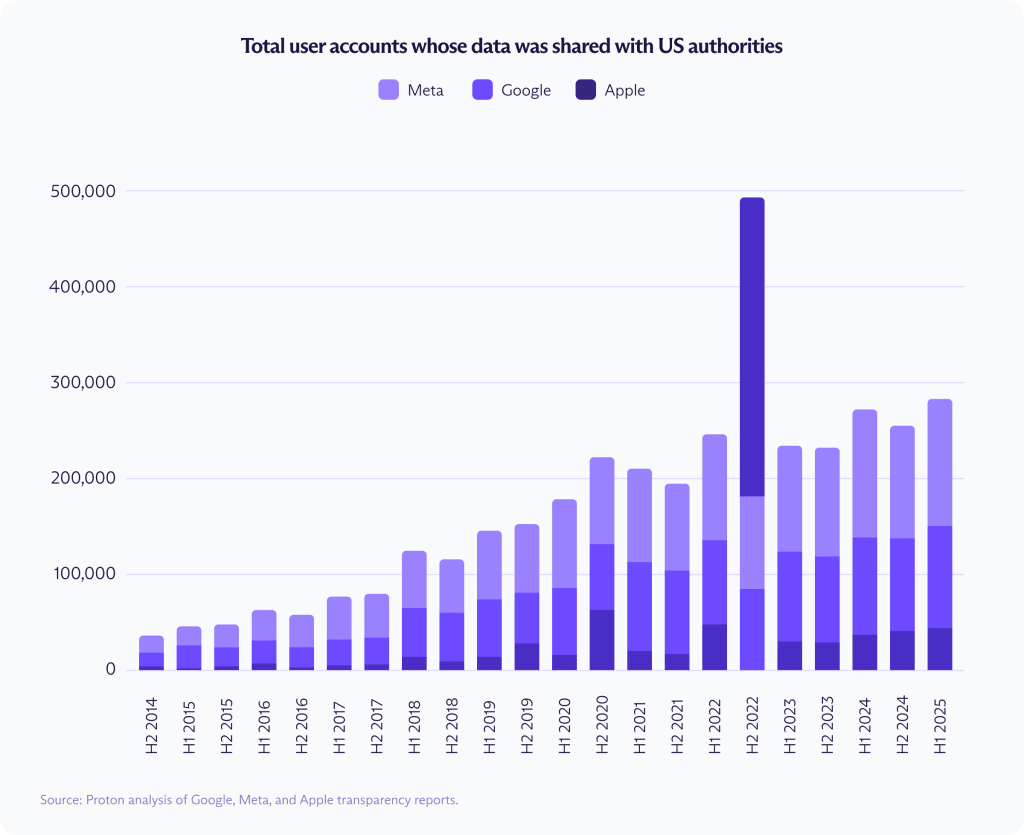
在此期间,Google 披露的帐户数量增长了 557%,Meta 增长了 668%,Apple 增长了 927%。仅 2025 年上半年,这些公司就披露了超过 282,000 个美国帐户的数据。

3.5 million 这一数字反映的是通过标准透明度披露报告的例行政府请求,不包括依据《外国情报监视法》(FISA) 提出的请求——此类请求依照国家安全规则单独报告,且详细信息较少。若计入 FISA 内容请求,截至 2024 年底,帐户披露总数约为 6.7 million。

2014 至 2024 年间,Meta 报告的 FISA 内容请求增长了 2,486%,Google 增长了 649%。Apple 未公布可追溯至 2014 年的可比数据,但其披露的 FISA 内容请求在 2018 至 2024 年间增长了 443%。数据截至 2024 年,是因为 FISA 报告尚未延伸至 2025 年,而例行透明度数据则不然。
欧盟的调取请求正急剧上升
欧洲政府的请求总量不及美国,但欧盟范围内的请求仍在快速增长。
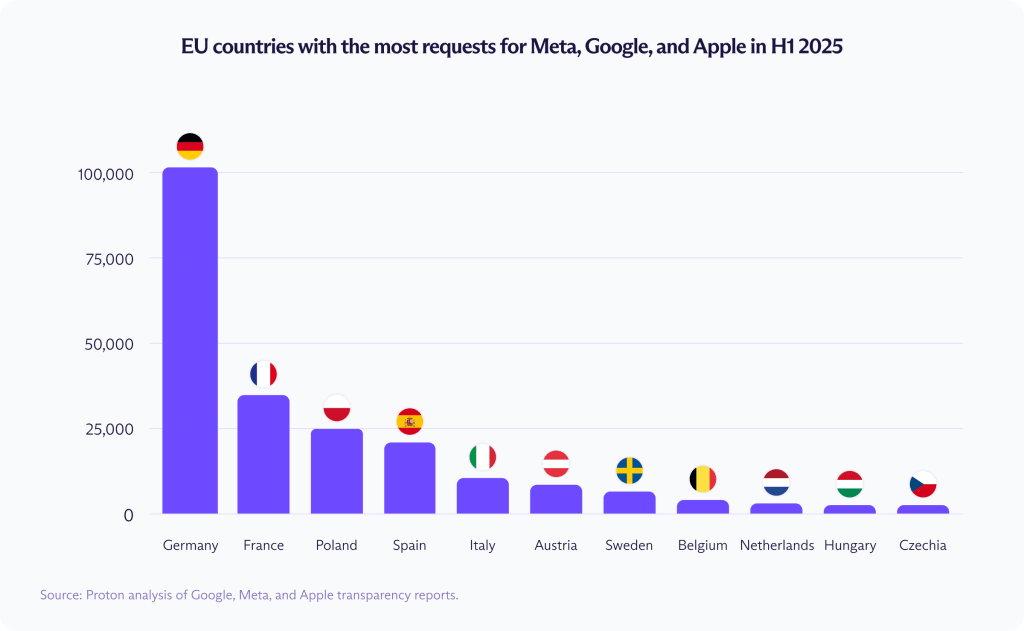
2025 年上半年,欧盟成员国请求调取 231,199 个用户帐户的数据,高于一年前同期的 164,472 个,涨幅约为 40%。自 2014 年末以来,请求总量已增长超过 1,100%。
增长并非均匀分布。2025 年上半年,德国占比最大,请求调取 101,811 个用户帐户的数据,其次是法国 (36,831)、波兰 (24,373) 和西班牙 (20,984)。
之所以如此,是因为大型科技公司始终让您的数据保持可读状态
问题并不在于公司遵守政府的合法请求,因为任何想在一国继续经营的公司都必须响应其有效法律命令。更深层的问题在于,Google、Meta 和 Apple 围绕收集并留存大量其自身仍可访问的个人数据构建了整个体系。如果一家公司掌握着密钥,它就能读取您的数据;如果它能读取您的数据,它就可能被强制交出这些数据。
端到端加密是限制可披露内容的最可靠方式,因为公司无法交出其无法解密的任何内容。充其量,它只能交出无法被有效读取的已加密材料。但在人们存储最敏感信息的各项服务中,大型科技公司一再表现出对此类保护缺乏兴趣,更不用说将其设为默认了。
大型科技公司的隐私保护还不够充分
大型科技公司如何处理用户隐私?当这些公司确实提供更强的保护时,这些保护往往是不完整的、可选的,或者很容易被撤销。以下是一些示例:
- Apple 的高级数据保护 (ADP) 功能——一项可将端到端加密扩展至更多 iCloud 数据的可选功能,涵盖备份、照片、备忘录和文件——默认并未启用。2025 年 2 月,在政府施压要求进一步访问加密的 iCloud 数据后,Apple 在英国移除了 ADP。Apple 后来对这一命令提出了异议,但那是在率先撤除此项保护之后。
- Meta 仅为 Instagram 会话提供端到端加密,且只作为一种可选功能,并仅限于部分地区。该公司近期宣布将从 Instagram 私信中完全移除 E2EE,理由是“极少有人”使用它。但深藏在设置中且默认不启用的隐私工具,对大多数人来说很容易被忽视。
- Google 在侵犯隐私方面并不陌生,仅 2025 年就被处以 $4.24 billion 罚款。2026 年 1 月,该公司同意支付 $68 million(新窗口),以了结一起诉讼,该诉讼指控 Google Assistant 在误触发后不当录制私人会话,用户声称这些录音随后被用于投放定向广告。
- AI 只是让大型科技公司的数据收割模式更加完善,使这些平台能够大规模收集和分析敏感信息——无论是为了改进模型、个性化广告,还是构建更完整的用户画像。例如,Meta 会处理所有用于广告的 Meta AI 互动,甚至包括私有会话中的互动,而 Google 则在各处加入了 Gemini,包括 Gmail 和 Android。
政府可以购买您的数据,或通过其他途径调取
对大型科技公司的请求只是问题的一部分。据 FBI 局长 Kash Patel 称,美国当局正在从数据经纪商处购买位置数据以追踪民众,这表明个人数据能够多么迅速地从看似私有的收集环节流入国家监控。
多年来,大型科技公司一直向用户灌输这样一种观念:便利、个性化以及更佳的互联网体验值得以隐私为代价。而这项交易实际造就的,是一个将个人数据视为资产的体系:大规模收集、多年存储,并可供任何能够购买或依法索取的人使用。
父母们已经知道这一体系辜负了他们的孩子
孩子的第一份数字痕迹往往产生于那些旨在尽可能长期收集、留存和分析数据的平台之中。最初只是一个学校帐户、第一个收件箱、一个消息应用或一个游戏登录帐号,但随着时间推移,它们可能成为庞大得多的用户画像的基础。一旦该画像形成且可被读取,任何对用户数据感兴趣的一方——包括 AI 系统、广告、数据经纪商和政府——都能从中获益,无论用户的年龄大小。
父母们深知这一点。

- 78% 担心孩子的在线隐私,其中 56% 非常担心。
- 70% 表示,孩子在网上的信息可能影响其人身安全。
- 59% 担心声誉受损。
- 56% 担心教育前景。
- 55% 担心未来的就业机会。
- 62% 表示,如果可以,他们会擦除孩子的全部在线历史,从头开始。
- 65% 认为大型科技公司正从孩子的个人数据中牟利。
如何从一开始就减少孩子暴露在数据收集之下
没有哪位父母能让自己的孩子完全置身数字世界之外。但家庭可以从源头上减少进入系统的个人数据量。
- 从默认私有的服务开始,例如使用一个不会为投放广告而扫描收件箱、也不会保留可读消息内容的私密电子邮件地址。
- 推迟不必要的帐户创建,因为许多平台会促使孩子过早注册。在以广告驱动的生态系统中创建的帐户越少,产生的数据就越少。
- 仔细审查学校和应用的默认设置,包括应用权限和隐私设置。教育平台、课堂工具以及家校沟通消息应用收集的数据可能超出家庭的预期。
- 在早期尽量少分享,包括照片、位置、活动历史,以及其他会随时间累积成庞大得多的画像的详细信息。
- 选择以加密为设计核心的服务,而非事后补救。深藏在设置中的可选隐私功能既容易被忽视,也容易被公司撤销。只有在从一开始就内建的情况下,保护才最为有效。
- 主动选择以隐私为设计核心的方案,因为大型科技公司指望大多数人沿用最省事的方式,即使这些默认设置偏向数据收集而非隐私。
下一代不必继承这个有缺陷的体系
这一代人已经在一个个以尽可能多地收集和留存个人数据为目的而构建的平台中度过了多年;当时几乎没有真正的替代选择,人们也鲜少意识到今天的选择会如何酿成明天的风险。孩子们不应从同样的起点出发。而且,由于数字生活的诸多方面都始于一个电子邮件地址,第一个收件箱将决定此后的一切是私密 (还是暴露)。
大型科技公司以可读形式保留的用户信息越多,政府能调取、AI 系统能分析以及数据经纪商能流通的数据就越多。隐私是一个架构问题,而不仅仅是策略问题。如果我们想要一个不同的未来,就需要让孩子在这套造就了现状的体系之外起步。