आज के बच्चे ऐसे सिस्टम के अंदर बड़े हो रहे हैं जो उनके ऑनलाइन आने के पहले पल से ही उनका डेटा इकट्ठा करने और सेव रखने के लिए बनाए गए हैं। जो चीज़ किसी स्कूल खाते, पहले ईमेल पते या मैसेजिंग ऐप के तौर पे शुरू होती है, वो उनके व्यवहार, रिश्तों और पहचान का लंबे समय तक चलने वाला रिकॉर्ड बन सकती है। और वो डेटा सालों तक एक्सेस में रह सकता है।
Proton के नए रिसर्च से पता चलता है कि इस सिस्टम के बड़े पैमाने पे क्या नतीजे सामने आए हैं। पिछले दशक में Google, Apple और Meta ने 3.5 मिलियन से ज़्यादा उपयोगकर्ता खातों का डेटा अमेरिकी अथॉरिटीज़ के साथ शेयर किया है, जो इन अनुरोधों की रिपोर्ट करना शुरू करने के बाद से 770% की बढ़ोतरी है। जब Foreign Intelligence Surveillance Act (FISA) के तहत दिए गए खुलासों को भी जोड़ा जाए, तो ये कुल आंकड़ा 6.9 मिलियन तक पहुंच जाता है।
बिग टेक को बच्चों के ऑनलाइन जीवन का ढांचा तय करने देने का असली खतरा यही है। व्यावसायिक मकसदों के लिए इकट्ठा किया गया डेटा — विज्ञापनों को टारगेट करने, AI को ट्रेन करने और प्रोफाइल बनाने के लिए — बाद में राज्य की निगरानी के सामने आ सकता है। अगर इस सिस्टम को गहरा होने दिया गया, तो अगली पीढ़ी ऐसा इंटरनेट विरासत में पाएगी जहां निजता धीरे-धीरे कमज़ोर नहीं होती, बल्कि शुरू से ही डिज़ाइन से ही खत्म होती है।
- रिसर्च, बिग टेक और सरकारी साझेदारियों के बारे में क्या दिखाता है
- ये सिर्फ इसलिए मुमकिन है क्योंकि बिग टेक आपका डेटा पढ़ने लायक हालत में रखता है
- माता-पिता पहले से जानते हैं कि ये सिस्टम उनके बच्चों के साथ नाइंसाफी कर रहा है
- शुरू से ही अपने बच्चे के डेटा के एक्सपोज़र को कम कैसे करें
- अगली पीढ़ी को ये खराब सिस्टम विरासत में लेना ज़रूरी नहीं है
रिसर्च, बिग टेक और सरकारी साझेदारियों के बारे में क्या दिखाता है
हमारे 2025 के विश्लेषण में पाया गया था कि बिग टेक के पास रखे उपयोगकर्ता डेटा तक सरकारी एक्सेस पिछले दशक में तेज़ी से बढ़ा था। ताज़ा ट्रांसपेरेंसी रिपोर्ट दिखाती हैं कि ये रुझान जारी है।
अमेरिकी अथॉरिटीज़ उपयोगकर्ता डेटा के लिए बिग टेक पे निर्भर रहती हैं
2014 के आखिर से 2025 की शुरुआत के बीच Google, Meta और Apple ने रूटीन अनुरोधों के जवाब में 3.5 मिलियन से ज़्यादा उपयोगकर्ता खातों का डेटा अमेरिकी अथॉरिटीज़ के साथ शेयर किया।
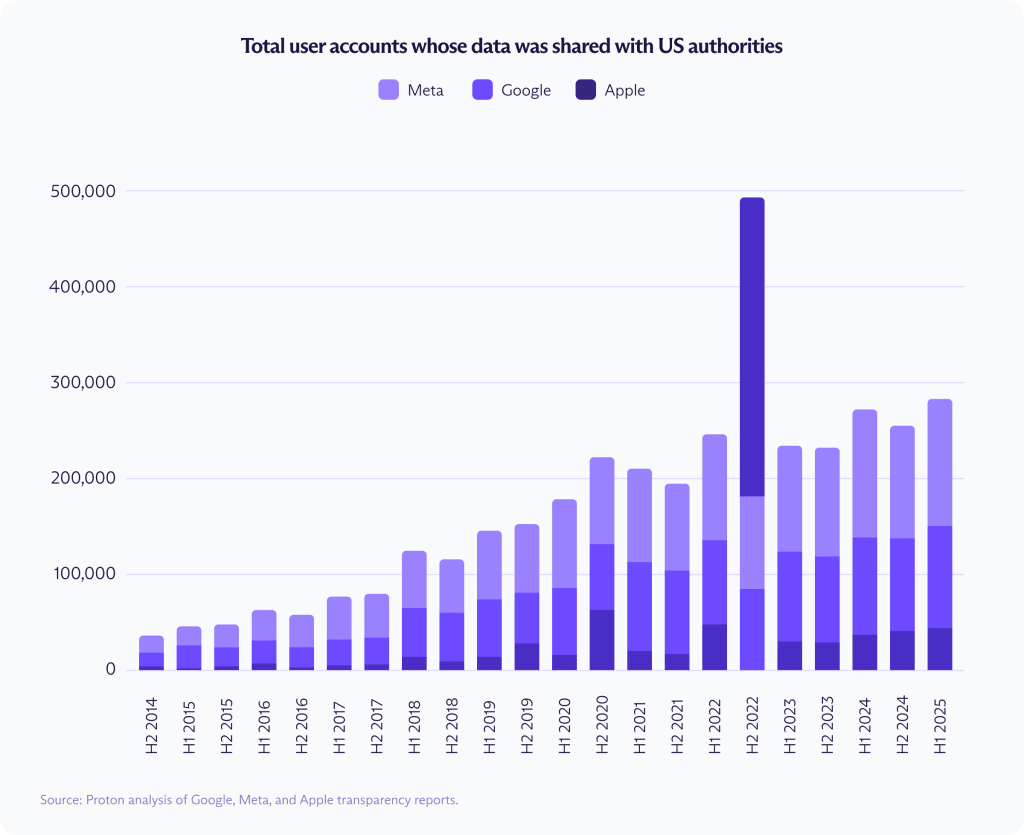
इस दौरान खुलासा किए गए खातों की संख्या Google में 557%, Meta में 668% और Apple में 927% बढ़ी। सिर्फ 2025 के पहले छह महीनों में ही इन कंपनियों ने 2,82,000 से ज़्यादा अमेरिकी खातों का डेटा खुलासा किया।

3.5 मिलियन का आंकड़ा स्टैंडर्ड ट्रांसपेरेंसी खुलासों के ज़रिए रिपोर्ट किए गए रूटीन सरकारी अनुरोधों को दर्शाता है। इसमें Foreign Intelligence Surveillance Act (FISA) के तहत किए गए अनुरोध शामिल नहीं हैं, जिनकी रिपोर्ट राष्ट्रीय सुरक्षा के नियमों के तहत, कम जानकारी के साथ, अलग से दी जाती है। जब FISA के कंटेंट अनुरोध शामिल कर लिए जाएं, तो 2024 के आखिर तक कुल लगभग 6.7 मिलियन खातों का खुलासा हो चुका है।

2014 से 2024 के बीच रिपोर्ट किए गए FISA कंटेंट अनुरोध Meta में 2,486% और Google में 649% बढ़े। Apple 2014 तक का तुलनीय डेटा पब्लिश नहीं करता, लेकिन उसके खुलासा किए गए FISA कंटेंट अनुरोध 2018 से 2024 के बीच 443% बढ़े। आंकड़े 2024 तक ही हैं क्योंकि FISA की रिपोर्टिंग अभी 2025 तक नहीं बढ़ी है, जो रूटीन ट्रांसपेरेंसी डेटा से अलग है।
EU के अनुरोध तेज़ी से बढ़ रहे हैं
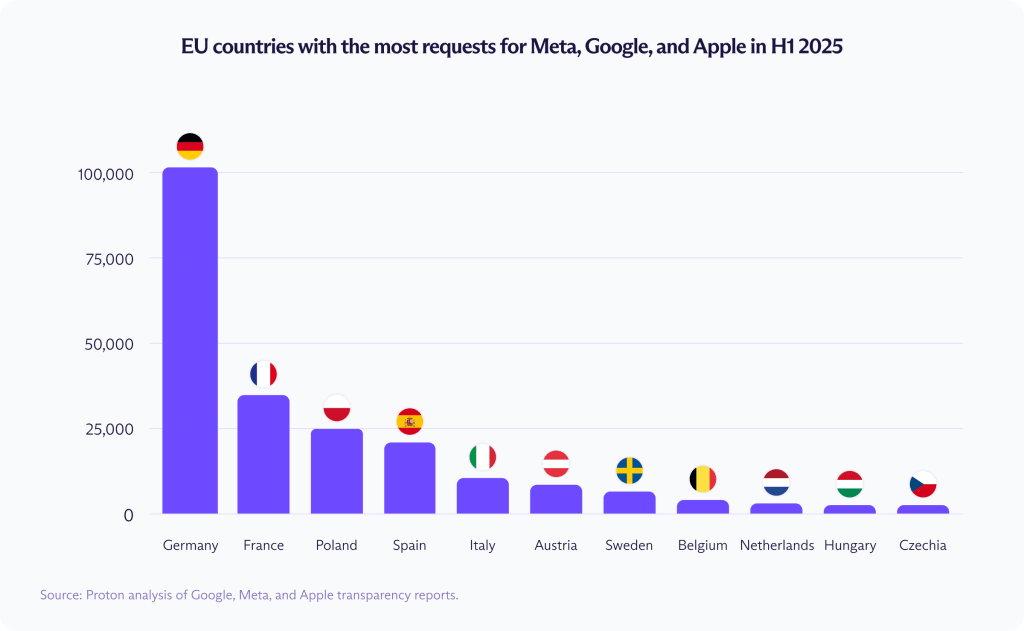
यूरोपीय सरकारें कुल आंकड़ों में अमेरिका की बराबरी नहीं करतीं, लेकिन पूरे यूरोपीय संघ में अनुरोध तेज़ी से बढ़ते जा रहे हैं।
2025 के पहले छह महीनों में EU के सदस्य देशों ने 2,31,199 उपयोगकर्ता खातों का डेटा मांगा, जो एक साल पहले इसी दौर में 1,64,472 था — यानी लगभग 40% की बढ़ोतरी। 2014 के आखिर से कुल अनुरोध 1,100% से ज़्यादा बढ़ चुके हैं।
ये बढ़ोतरी बराबर नहीं बंटी है। 2025 के पहले छह महीनों में सबसे बड़ा हिस्सा जर्मनी का रहा, जिसने 1,01,811 उपयोगकर्ता खातों का डेटा मांगा। उसके बाद फ्रांस (36,831), पोलैंड (24,373) और स्पेन (20,984) रहे।
ये सिर्फ इसलिए मुमकिन है क्योंकि बिग टेक आपका डेटा पढ़ने लायक हालत में रखता है
समस्या कंपनियों के कानूनी सरकारी अनुरोधों को मानने की नहीं है, क्योंकि जो कंपनी किसी देश में काम जारी रखना चाहती है, उसे वहां के वैध कानूनी आदेशों का जवाब देना ही पड़ता है। असली गहरी समस्या ये है कि Google, Meta और Apple ने ऐसे सिस्टम बनाए हैं जो बड़ी मात्रा में पर्सनल डेटा इकट्ठा करने और सेव रखने पे आधारित हैं, और ऐसे फॉर्म में जिसे वो अब भी एक्सेस कर सकते हैं। अगर कंपनी के पास चाबी हैं, तो वो आपका डेटा पढ़ सकती है। और अगर वो आपका डेटा पढ़ सकती है, तो उसे वो डेटा सौंपने के लिए मजबूर किया जा सकता है।
शुरु-से-अंत तक एन्क्रिप्शन इस बात को सीमित करने का सबसे पक्का तरीका है कि क्या खुलासा हो सकता है, क्योंकि कोई कंपनी कुछ भी ऐसा सौंप नहीं सकती जिसे वो डीक्रिप्ट नहीं कर सकती। सबसे ज़्यादा वो एन्क्रिप्ट किया हुआ मटीरियल दे सकती है जिसे असरदार तरीके से पढ़ा नहीं जा सकता। लेकिन बिग टेक ने बार-बार दिखाया है कि उन सेवाओं में, जहां लोग अपनी सबसे सेंसिटिव जानकारी रखते हैं, उस तरह की सुरक्षा देने में, और फिर उसे डिफॉल्ट बनाने में, उनकी खास दिलचस्पी नहीं है।
बिग टेक की निजता सुरक्षा काफी नहीं है
बिग टेक उपयोगकर्ता निजता को कैसे हैंडल करता है? जब ये कंपनियां मज़बूत सुरक्षा देती हैं, तो वो अक्सर आंशिक, ऑप्शनल या आसानी से बदली जा सकने वाली होती हैं। यहां कुछ उदाहरण हैं:
- Apple की Advanced Data Protection (ADP) खासियत — एक ऑप्शनल खासियत जो शुरु-से-अंत तक एन्क्रिप्शन को और ज़्यादा iCloud डेटा तक बढ़ाती है, जिसमें बैकअप, फोटो, नोट्स और फ़ाइलें शामिल हैं — डिफॉल्ट रूप से सक्षम नहीं होती। फरवरी 2025 में, एन्क्रिप्ट किए गए iCloud डेटा तक ज़्यादा एक्सेस की सरकारी मांग के दबाव के बाद Apple ने UK में ADP हटा दिया। Apple ने बाद में इस आदेश को चुनौती दी, लेकिन वो भी पहले सुरक्षा वापस लेने के बाद ही।
- Meta, Instagram की बातचीत के लिए शुरु-से-अंत तक एन्क्रिप्शन सिर्फ एक ऑप्शनल खासियत के तौर पे देता है, और वो भी सिर्फ कुछ इलाकों में। कंपनी ने हाल ही में घोषणा की है कि वो Instagram DMs से E2EE पूरी तरह हटाएगी, कहते हुए कि “बहुत कम लोगों” ने इसे इस्तेमाल किया। लेकिन ऐसे निजता टूल्स जो सेटिंग में गहरे दबे होते हैं और डिफॉल्ट रूप से सक्षम नहीं होते, ज़्यादातर लोगों के लिए उन्हें मिस करना आसान होता है।
- Google, निजता के उल्लंघनों के मामले में नया नहीं है — उसने सिर्फ 2025 में ही $4.24 बिलियन के जुर्माने झेले हैं। जनवरी 2026 में कंपनी ने एक मुकदमे को सुलझाने के लिए $68 मिलियन देने पे सहमति दी(नई विंडो), जिसमें आरोप था कि Google Assistant ने फर्ज़ी एक्टिवेशन के बाद निजी बातचीत को गलत तरीके से रिकॉर्ड किया, और उपयोगकर्ताओं का दावा था कि उन रिकॉर्डिंग का इस्तेमाल फिर टारगेटेड विज्ञापनों के लिए किया गया।
- AI ने तो बिग टेक के डेटा-हार्वेस्टिंग मॉडल को और बेहतर बना दिया है, जिससे इन प्लैटफॉर्म को बड़े पैमाने पे सेंसिटिव जानकारी इकट्ठा और विश्लेषण करने की सुविधा मिली है — चाहे मॉडल बेहतर बनाने के लिए, विज्ञापनों को पर्सनलाइज़ करने के लिए, या और पूरे उपयोगकर्ता प्रोफाइल बनाने के लिए। उदाहरण के लिए, Meta सारी Meta AI इंटरैक्शन को विज्ञापनों के लिए प्रोसेस करता है, निजी बातचीत के अंदर भी, जबकि Google ने Gemini को हर जगह जोड़ दिया है, जिसमें Gmail और Android शामिल हैं।
सरकारें आपका डेटा खरीद सकती हैं या उसे कहीं और से मांग सकती हैं
बिग टेक के अनुरोध तस्वीर का सिर्फ एक हिस्सा हैं। FBI डायरेक्टर Kash Patel के मुताबिक, अमेरिकी अथॉरिटीज़ लोगों को ट्रैक करने के लिए डेटा ब्रोकर्स से लोकेशन डेटा खरीद रही हैं, जो दिखाता है कि पर्सनल डेटा निजी लगने वाले इकट्ठा किए गए डेटा से राज्य की निगरानी तक कितनी जल्दी पहुंच सकता है।
सालों तक बिग टेक ने उपयोगकर्ताओं को ये बात बेची है कि सुविधा, पर्सनलाइज़ेशन और बेहतर इंटरनेट अनुभव निजता का समझौता करने लायक हैं। उस सौदे ने असल में ऐसा सिस्टम बनाया है जहां पर्सनल डेटा को एक एसेट की तरह ट्रीट किया जाता है: बड़े पैमाने पे इकट्ठा किया गया, सालों तक स्टोर किया, और जो भी उसे खरीद सके या कानूनी तौर पे मांग सके, उसके लिए उपलब्ध।
माता-पिता पहले से जानते हैं कि ये सिस्टम उनके बच्चों के साथ नाइंसाफी कर रहा है
बच्चे की पहली डिजिटल निशानियां अक्सर ऐसे प्लैटफॉर्म के अंदर बनती हैं जो जितना हो सके उतने समय तक डेटा इकट्ठा करने, सेव रखने और विश्लेषण करने के लिए बनाए गए हैं। जो चीज़ स्कूल खाते, पहले इंबॉक्स, मैसेजिंग ऐप या गेमिंग लॉगइन के तौर पे शुरू होती है, वो वक़्त के साथ कहीं बड़ी प्रोफाइल की नींव बन सकती है। एक बार वो प्रोफाइल बन जाए और उसे पढ़ा जा सके, तो वो हर उस शख्स के काम आती है जिसे उपयोगकर्ता डेटा में दिलचस्पी है, चाहे वो AI सिस्टम हों, विज्ञापन हों, डेटा ब्रोकर हों या सरकारें — चाहे उपयोगकर्ता की उम्र कुछ भी हो।
माता-पिता ये जानते हैं।

अमेरिकी माता-पिता के बीच हुए एक Proton सर्वे में पाया गया कि:
- 78% अपने बच्चे की ऑनलाइन निजता को लेकर चिंतित हैं, जिनमें 56% बहुत ज़्यादा चिंतित हैं।
- 70% ने कहा कि उनके बच्चे के बारे में ऑनलाइन मौजूद जानकारी उनकी पर्सनल सेफ्टी को प्रभावित कर सकती है।
- 59% प्रतिष्ठा को होने वाले नुकसान को लेकर चिंतित हैं।
- 56% पढ़ाई के भविष्य के मौकों को लेकर चिंतित हैं।
- 55% आने वाली नौकरी के मौकों को लेकर चिंतित हैं।
- 62% ने कहा कि अगर मुमकिन होता तो वो अपने बच्चे का पूरा ऑनलाइन हिस्ट्री मिटाकर नई शुरुआत करते।
- 65% का मानना है कि बिग टेक उनके बच्चे के पर्सनल डेटा से मुनाफा कमाता है।
शुरू से ही अपने बच्चे के डेटा के एक्सपोज़र को कम कैसे करें
कोई भी माता-पिता अपने बच्चे को डिजिटल दुनिया से पूरी तरह बाहर नहीं रख सकता। लेकिन परिवार ये कम कर सकते हैं कि शुरू में ही सिस्टम में कितना पर्सनल डेटा दर्ज हो।
- निजी-बाय-डिफॉल्ट सेवाओं से शुरुआत करें, जिनमें एक ऐसा प्राइवेट ईमेल पता शामिल है जो विज्ञापनों के लिए इंबॉक्स स्कैन नहीं करता और न ही पढ़ने लायक संदेश कंटेंट सेव रखता है।
- ज़रूरी न होने पे खाता बनवाने में देर करें, क्योंकि कई प्लैटफॉर्म बच्चों को ज़रूरत से पहले ही साइनअप करने पे दबाव डालते हैं। विज्ञापन-आधारित इकोसिस्टम के अंदर जितने कम खाते बनें, उतना कम डेटा होगा।
- स्कूल और ऐप की डिफॉल्ट सेटिंग्स को ध्यान से देखें, जिनमें ऐप परमिशन और निजता सेटिंग शामिल हैं। एजुकेशनल प्लैटफॉर्म, क्लासरूम टूल्स और माता-पिता-शिक्षक मैसेजिंग ऐप उम्मीद से ज़्यादा डेटा इकट्ठा कर सकते हैं।
- शुरुआत में कम शेयर करें, जिसमें फोटो, लोकेशन, एक्टिविटी हिस्ट्री और वो छोटी-छोटी जानकारी शामिल है जो वक़्त के साथ कहीं बड़ी प्रोफाइल में जुड़ सकती है।
- एन्क्रिप्शन को डिज़ाइन का हिस्सा बनाकर चुनें, बाद की सोच के तौर पे नहीं। सेटिंग में गहरे दबी ऑप्शनल निजता खासियतें देखना आसान नहीं होता और कंपनियों के लिए उन्हें बदलना भी आसान होता है। सुरक्षा तभी सबसे असरदार होती है जब वो शुरू से ही अंदर बनी हो।
- निजता-बाय-डिज़ाइन चुनने में जानबूझकर अपना रुख रखें, क्योंकि बिग टेक कंपनियों को भरोसा होता है कि ज़्यादातर लोग जो सबसे आसान है वही चुनते रहेंगे, चाहे वो डिफॉल्ट निजता की बजाय डेटा इकट्ठा करने को तरजीह देते हों।
अगली पीढ़ी को ये खराब सिस्टम विरासत में लेना ज़रूरी नहीं है
मौजूदा पीढ़ी सालों तक ऐसे प्लैटफॉर्म के अंदर रही है जो जितना हो सके उतना पर्सनल डेटा इकट्ठा करने और सेव रखने के लिए बनाए गए थे; असली विकल्प बहुत कम थे और ये समझ बहुत कम थी कि आज के फैसले कल के जोखिम कैसे बना सकते हैं। बच्चों को वहीं से शुरुआत नहीं करनी चाहिए। और चूंकि डिजिटल जीवन की शुरुआत काफी हद तक ईमेल पते से होती है, वो पहला इंबॉक्स तय कर सकता है कि आगे जो कुछ भी होगा वो कितना निजी (या खुला) होगा।
जितनी ज़्यादा उपयोगकर्ता जानकारी बिग टेक पढ़ने लायक फॉर्म में रखेगा, उतना ज़्यादा डेटा सरकारें मांग सकती हैं, AI सिस्टम विश्लेषण कर सकते हैं और डेटा ब्रोकर घुमा-फिरा सकते हैं। निजता ढांचे का मामला है, सिर्फ नीति का नहीं। अगर हमें कोई और भविष्य चाहिए, तो बच्चों की शुरुआत उन सिस्टम के बाहर से करनी होगी जिन्होंने ये वाला सिस्टम बनाया है।